Automation heeft een aantrekkelijke belofte.
Sneller. Efficiënter. Consistenter. Minder handwerk.
Maar consistent is niet automatisch hetzelfde als correct.
Stel dat in je CMDB bij 5% van de servers de verkeerde eigenaar staat geregistreerd. Zolang iemand daar af en toe naar kijkt, is dat vervelend. Maar koppel diezelfde informatie aan een geautomatiseerd proces dat wijzigingen goedkeurt, incidenten routeert of compliance-controles uitvoert, en er gebeurt iets anders.
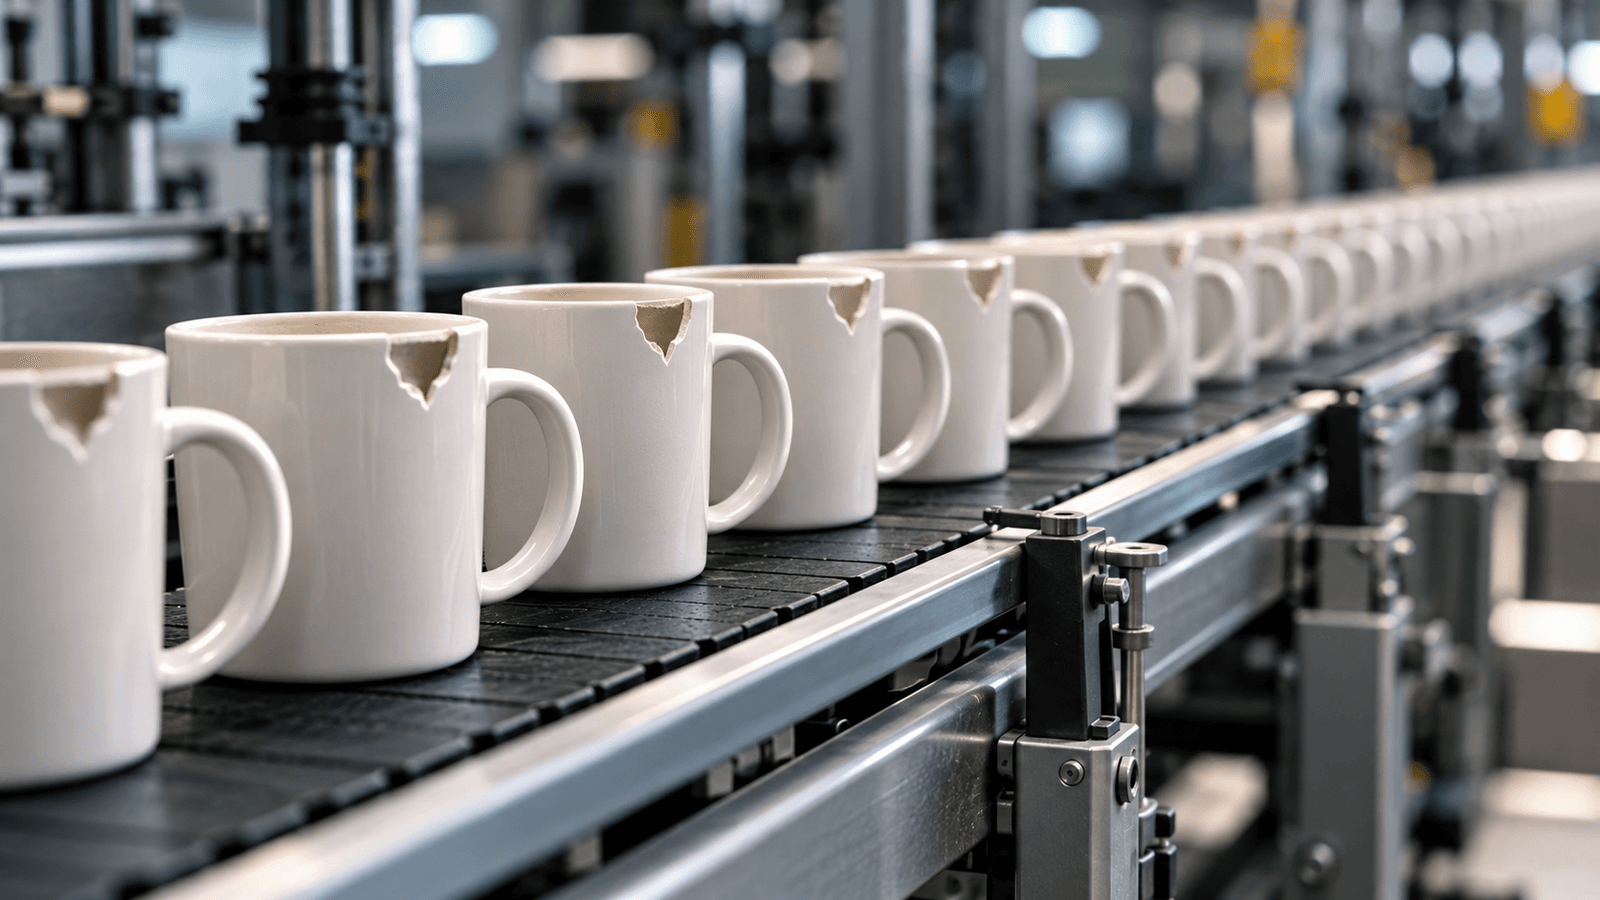
De automation doet precies wat we hem gevraagd hebben. Iedere keer opnieuw.
Snel. Consequent. En fout.
Dat geldt niet alleen voor data.
Een verkeerde business rule kan tientallen keren worden uitgevoerd.
Een verkeerde relatie kan iedere impactanalyse beïnvloeden.
Een verkeerde interpretatie kan tot “verrassende” resultaten leiden.
Een verkeerde classificatie kan structureel tot de verkeerde workflow leiden.
Automation haalt de menselijke vertraging uit een proces.
Maar daarmee verdwijnt ook de vertraging van de fout.
Daar zit voor mij een belangrijk verschil tussen digitaliseren en automatiseren.
Als een proces grotendeels door mensen wordt uitgevoerd, blijven fouten vaak lokaal. Naarmate een ITSM-platform meer zelfstandig gaat doen, kunnen fouten zich veel sneller door processen en systemen verspreiden.
De vraag vóór automation is daarom niet alleen:
Kunnen we dit automatiseren?
Maar ook:
Vertrouwen we de informatie, regels en relaties waarop deze automation gaat handelen?
Want automation maakt goede informatie heel waardevol.
En slechte informatie heel schaalbaar.
Over de auteur
Rob Woerden — CMDB- en service-informatiespecialist
Rob Woerden werkt ruim 25 jaar in IT-servicemanagement en hielp in die tijd tientallen organisaties hun CMDB en service-informatie op orde te krijgen. Met FlowITSM richt hij zich op betrouwbare service-informatie als basis voor AI-ready, compliant en service-centric IT.
Bekijk profiel